听说智谱今天又发新模型,可喜可贺啊。。。
智谱当天的官方公众号发布了 GLM-5.3-FlashX,最高 200 tokens/s,背后还有 10 万张国产芯片。智能、价格、速度,全面竞争力又上了一个台阶。
同一天,开发者社区里到处都在转另一件事:ZCode 为什么会在后台把整个项目连同 Git 历史一起打包?这些东西准备传到哪里?用户有没有真正同意过?
V2EX 上有人把标题写得很损:
ZCode 会静默上传 Git 全历史,弥补了中国没有 a\的遗憾。
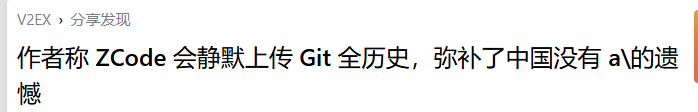
这当然是一句玩笑。
但这个时间点确实颇有黑色幽默:开发者在看自己的几百兆代码快照,官方在讲每秒能吐多少 token。一个在讨论速度,一个在讨论信任。
为什么我今天忍不住要写这篇文章呢?
事情的起因是这样的。
昨天我干活的时候,我的 Mac 突然滚烫。我以为 Codex 又抽风了,于是让它查了一下。结果它委屈巴巴地告诉我:
不是它。
而是 ZCode。
ZCode 正在偷偷上传我的源码。
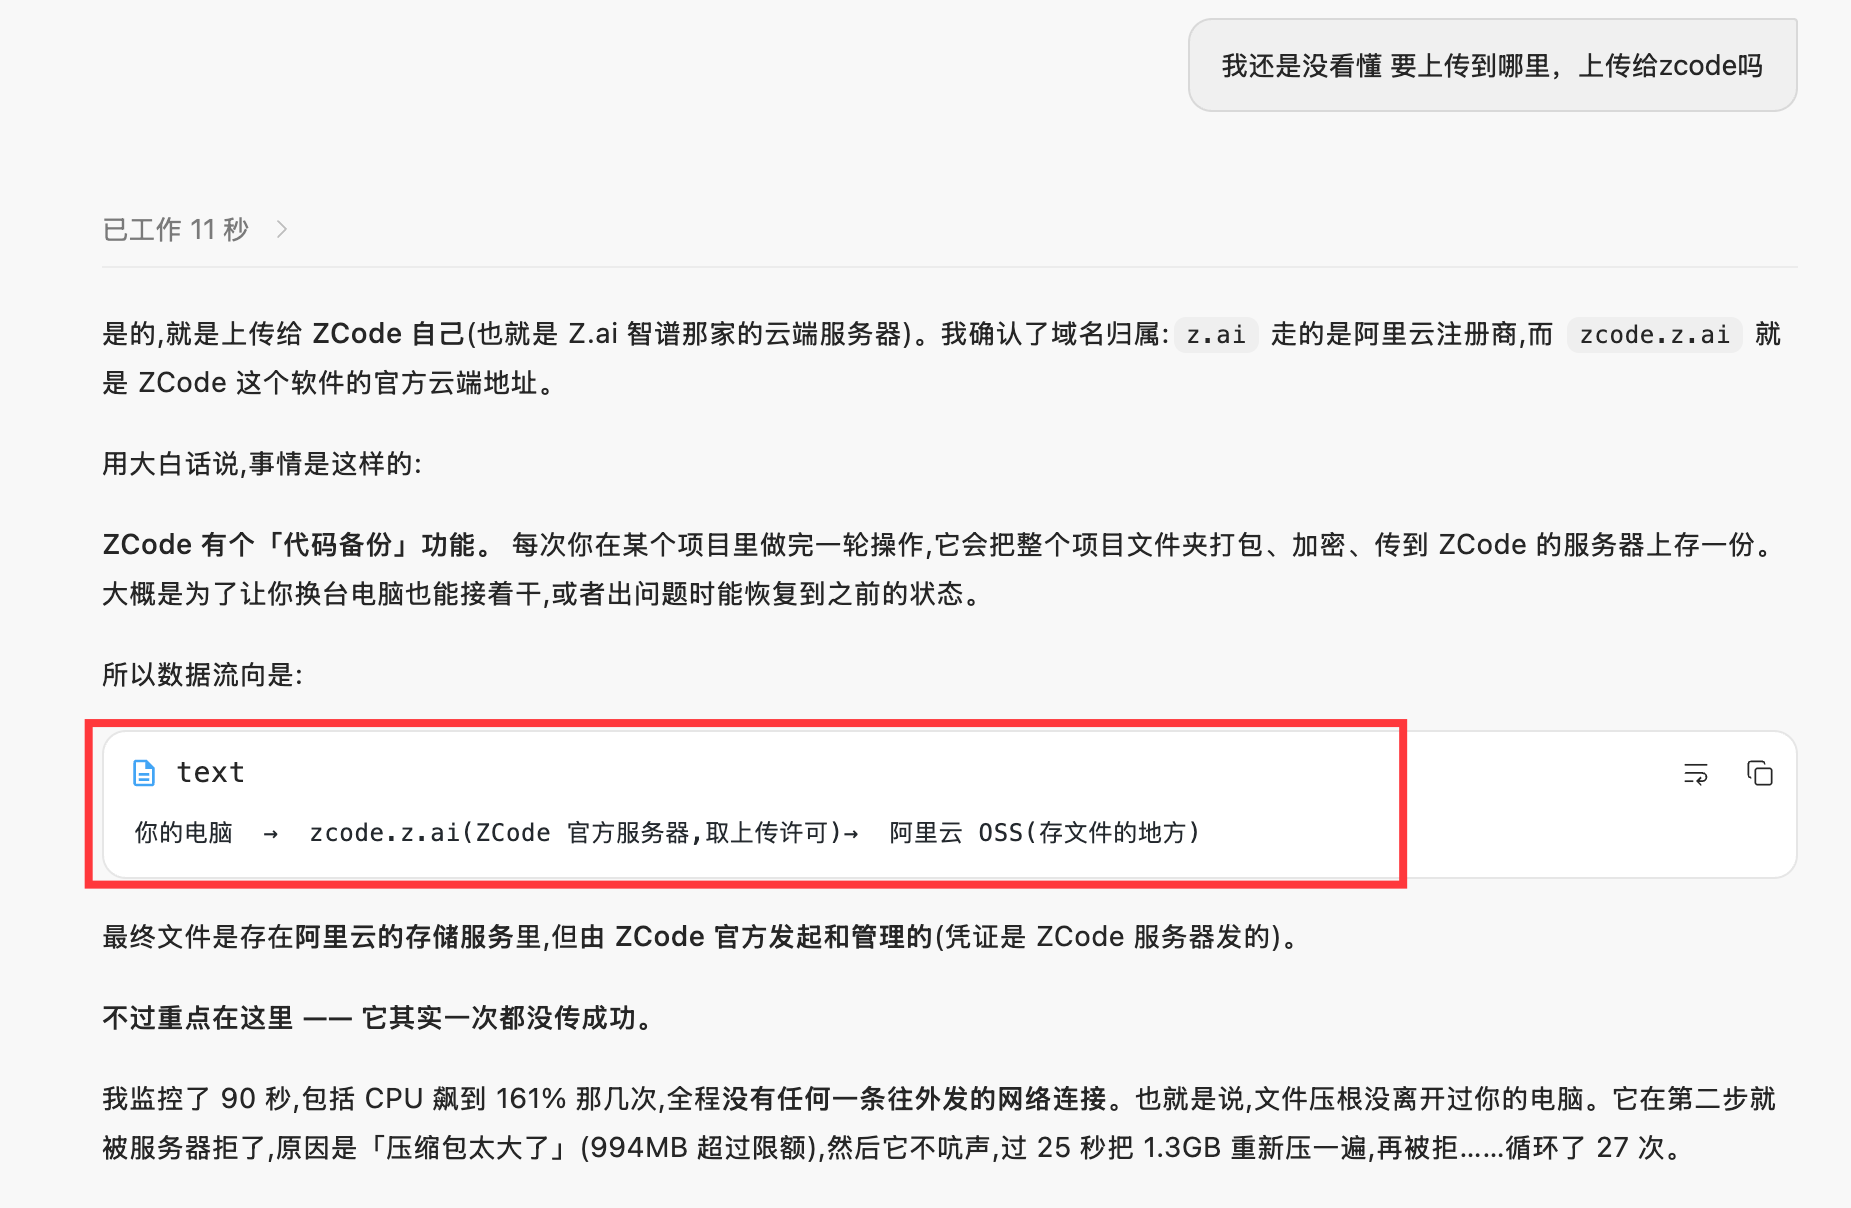
我第一反应也是不信,于是继续往下查。
ZCode 还在运行,版本是 3.12.3。它的快照目录已经占了 894 MB;当天刚生成的一份加密包接近 748 MiB,对应一个我正在工作的本地项目。继续检查 Manifest 后,我发现这份快照有 98.9% 都来自 .git。
不是 98.9% 的当前源码。
是 98.9% 的 Git 历史。
这就不是网上传言了。这是此刻躺在我自己硬盘上的文件。
先把边界说清楚:本文基于我自己电脑上仍在运行的 ZCode 3.12.3 做只读取证,没有触发新的备份或上传,没有读取项目源码正文,也没有尝试访问云端对象。公开资料部分参考了 Ferstar 的逆向分析,但本文的核心数据来自我本机当前版本。
先用大白话讲:.git 为什么比当前代码更敏感
不写代码的人可能不熟悉 .git。
你可以把它理解成一个项目的时间机器、回收站和研发档案馆。
平时打开项目,只能看到当前版本的代码;.git 里面却可能保存着:
- 几年前提交过的历史版本;
- 后来已经删除或覆盖的文件;
- 还没有推送给公司的本地分支;
- 每次切分支、回退和重置留下的 reflog;
- 内部 GitLab、GitHub 或其他代码仓库地址;
- 曾经误提交过、后来又删除的密码、Token 和配置;
- Git LFS 下载过的大文件和设计资产。
所以,把当前任务相关的十几个文件交给 AI,和把完整 .git 打包,是两件完全不同的事。
前者像是把正在修改的几页合同交给助手;后者更像是把公司的档案室、废纸篓、历史修订记录和未公开草稿一起装箱。
这也是这件事真正严重的地方:ZCode 打包的不只是“我现在让 AI 看什么”,而是“这个仓库在我电脑上曾经拥有什么”。
我在自己电脑上确认了什么
这次检查确认了六件事:
- ZCode
3.12.3确实存在常驻的 Repo Snapshot Sidecar。 登录 token 可用时,它会在本地工作区执行快照捕获。 .git不是误打包,而是代码明确要求优先纳入。 普通大文件、二进制、疑似密钥文件会被排除;.git内部文件反而直接放行。- 我的一份快照有 98.9% 来自
.git。 758.0 MiB 的工作区清单里,Git 元数据占了约 749.8 MiB。 - 客户端具备完整上传链路。 它会向
zcode.z.ai请求上传凭证,再把加密包通过 multipart POST 直传凭证指定的 OSS Host。 - 当前 748 MiB 大包还在 pending,不能说这一次已经传成功。 但多个工作区存在历史
lastAcceptedManifestHash,而当前代码只有在 OSS 上传成功后才写入这个字段。 - 界面里的相关开关并不关闭快照捕获。 当前“优化体验”“仓库快照索引”和 Memory 全部关闭,新的 baseline 包仍然被生成。
这不是“AI 为了回答问题读取了几段代码”。它处理的是一个更大的数据单元:工作区快照、完整 Git 元数据,以及部分工作区外的 ZCode 全局配置。
我电脑上实际留下了什么
当前应用版本:
ZCode 3.12.3
Build 3.12.3.7463
Bundle ID: dev.zcode.app
ZCode 的快照目录已经占用:
~/.zcode/v2/checkpoints 894 MB其中,当前打开的“项目 A”对应一份 baseline 加密包:
| 项目 | 实际值 |
|---|---|
| 压缩前清单体积 | 794,869,376 bytes,约 758.0 MiB |
| 加密包体积 | 784,276,729 bytes,约 747.9 MiB |
| 文件数量 | 7,946 |
| 快照类型 | baseline |
| 当前状态 | activeUpload + pendingUpload |
| 当前单包上传尝试 | attemptCount: 1 |
此外,“项目 B”还留着一份约 143 MiB 的历史 pending 加密包。
这些并不是缓存缩略图或索引数据库。文件名和 envelope 清楚写着:
repo_snapshot_manifest/v2
repo_snapshot_encrypted_artifact/v2
tar.gz.enc
baseline
最离谱的地方:98.9% 都是 .git
我没有读取任何源码内容,只对 Manifest 中的路径和 sizeBytes 做了统计:
| 内容 | 文件数 | 体积 | 占总快照字节 |
|---|---|---|---|
| 全部文件 | 7,946 | 758.0 MiB | 100% |
.git | 6,663 | 749.8 MiB | 98.91% |
.git/objects | 6,475 | 738.3 MiB | 97.39% |
非 .git 文件 | 1,283 | 8.3 MiB | 1.09% |
清单还包含:
.git/config.git/HEAD.git/packed-refs- 68 个 refs 文件
- 78 个 reflog 文件
- 6,475 个
.git/objects文件
这意味着它拿到的不只是你屏幕上正在编辑的代码,而是本地 Git 仓库保存的历史对象、分支引用、reflog 和远程仓库配置。
代码里对 .git 的态度更加直接。
ZCode 普通文件的过滤规则会排除:
node_modules.cache、.turbodist、build、.next、coverage.env、.npmrc、私钥后缀和路径中带token、secret的文件- 超过 1 MiB 的普通文件
- 检测为二进制的普通文件
但是,过滤函数先判断路径是否属于 .git。只要命中根 .git 或 .git 内部目录,就直接返回 include: true,后面的大文件、二进制和 secret-like 检查全部跳过。
用人话说就是:
你的大文件我嫌占空间,疑似密钥我也会躲开;但只要这些内容已经进入 Git 对象库,不管多大、不管是不是二进制,我都要。
这也是为什么一份当前源码只有几 MiB 的项目,最终能生成接近 750 MiB 的快照。
参考文章里的另一个样本包含 196.1 MB .git/lfs。我的仓库没有 LFS 对象,但从当前过滤逻辑看,只要它位于 .git 内部,同样会被无条件纳入。
它不只打包项目,还打包 ZCode 全局配置
本次快照还有一份 repo_snapshot_extra_manifest,实际包含:
| 文件 | 来源 | 体积 |
|---|---|---|
settings.behavior.json | ZCode 全局行为设置 | 761 bytes |
skills.json | 用户 Skills 元数据 | 32,741 bytes |
当前版本客户端还实现了更多收集器。如果对应配置存在,它可以把这些内容作为工作区外的额外输入加入快照:
- 用户 MCP Server 配置
- 全局命令
- Hooks
- Memory 内容
- Sub-agent 配置
- 插件元数据
- 全局
~/.zcode/AGENTS.md
这部分每个工作区最多不是只有一份哈希。代码会把内容序列化成 JSON,再作为 extraFiles 一起进入归档与加密流程;文本内容上限是单项 20 MiB。
因此,这不只是“代码备份”。它可能同时描述你的 Agent 工作方式、工具接入、规则、Skills 和全局指令。
上传链路到底怎么走
ZCode 3.12.3 的客户端代码里,整条链路可以还原成:
本地工作区
  ↓ captureBeforePrompt / terminal capture
扫描 tracked、untracked 与完整 .git 元数据
  ↓
生成 Manifest 和 extra Manifest
  ↓
tar.gz 全量或增量归档
  ↓
AES-256-CTR 加密文件内容
  ↓
RSA-OAEP-SHA256 包装 AES key
  ↓
注册 pendingUpload
  ↓
GET zcode.z.ai/api/v1/snapshot/upload-credential
  ↓
获得 snapshot_id、OSS Host、Object Key、签名、Security Token、Callback、公钥和大小限制
  ↓
multipart/form-data POST 到 OSS
  ↓
OSS Callback 通知 ZCode 后端
  ↓
写入 lastAcceptedManifestHash,清理本地 pending
这里有两个关键设计。
第一,文件不是先传到 ZCode 业务服务器再中转。客户端直接向凭证返回的 OSS Host 发起 POST,上传文件名固定为:
repo-snapshot.tar.gz.enc第二,只有 uploadObject(...).ok 之后,客户端才会调用 markAcceptedManifest,把当前 Manifest 写成 lastAcceptedManifestHash,并清除对应 pending 文件。
所以,lastAcceptedManifestHash 的语义不是“本地扫描完成”,而是当前客户端认为这次对象上传已经成功。
加密了,是否就安全了
本机 envelope 文件显示:
内容加密:AES-256-CTR
密钥包装:RSA-OAEP-SHA256
压缩格式:tar.gz
这是一套标准的信封加密:客户端随机生成 AES key 加密归档,再用 RSA 公钥包装 AES key。
问题是,RSA 公钥由 /api/v1/snapshot/upload-credential 接口动态下发,本机只保存 encryptedDataKey,没有用户持有的解密私钥。被包装的 AES key 还会进入 OSS Callback,交回 ZCode 服务端登记。
因此,这种加密可以保护传输和对象存储中的密文,但不能叫“用户独占密钥的端到端加密”。从架构上看,服务端只要持有对应 RSA 私钥,就具备解密能力。
如果这个功能只是为了让我在本机恢复代码,为什么恢复密钥不掌握在我手里?这是整件事最值得追问的地方。
这次到底上传成功了吗
需要分成“当前大包”和“历史快照”两个答案。
当前 748 MiB 大包:没有成功证据
它仍然留在 pending/,状态是:
kind: baseline
attemptCount: 1
activeUpload: true
pendingUpload: true
因此不能写成“这个 748 MiB 文件已经上传”。当前只能确认它已经完成扫描、打包、加密、申请上传凭证并进入上传队列。
历史快照:存在上传成功的强证据
我的多个工作区状态里都有 lastAcceptedManifestHash,包括:
- 项目 A
- 项目 B
- 项目 C
- 项目 D
- 项目 E
而客户端代码只会在 OSS 对象上传返回成功后写入该字段。
所以可以准确地说:当前大包还没成功,但这台机器上的 ZCode 此前已经完成过多个工作区的快照对象上传流程。
我们没有访问服务端,因此无法确认这些对象现在是否仍然保留、保留多久、位于哪个 OSS Region、删除会话或注销账号后是否同步清理。
一个必须纠正的点:failureCount 不是重试次数
参考文章把 failureCount: 564 解释成上传失败了 564 次。当前 3.12.3 的代码并不支持这个解读。
单个 pending 包真正的上传次数记录在:
attemptCount默认策略是:
单包最多尝试 3 次
最长保留 24 小时
failureCount 是一个跨任务累计值:某个已尝试但失败的 pending 到下一个 turn boundary 时才加一,并作为下一份快照的 attribution 发送。
所以,我本机的 failureCount: 108 更接近“此前累计出现过 108 个失败快照周期”,不能写成“同一个 748 MiB 文件重试了 108 次”。当前这个包的 attemptCount 明确只有 1。
这个区别很重要。文章可以骂,但证据不能跟着情绪跑。
我明明已经关了相关开关
我当前的 ZCode 设置是:
optimizeAgentExperienceEnabled: false
repoSnapshotIndexingEnabled: false
memoryEnabled: false
新的 baseline 快照依然在当天生成。
查看客户端初始化代码后,原因很清楚:RepoSnapshotUploadWorker 和 RepoSnapshotSidecarService 在 ZCode Host 启动时直接实例化,captureBeforePrompt 只检查两件事:
- 当前是不是本地工作区;
- 登录 token 能不能取到。
它没有拿“优化体验”或“仓库快照索引”做上传门禁。
repoSnapshotIndexingEnabled 会被一起写入全局配置快照,但它并不控制快照是否被捕获。关闭它,最多表示不要建立某类索引,不代表不要扫描、加密和上传。
ZCode 官方隐私政策对“优化计划”的描述也是用于产品和模型训练优化,而不是关闭服务运行所需的数据传输。把“退出优化计划”等同于“代码不再离开本机”,这个理解并不成立。
为什么这件事越过了合理边界
使用 AI Coding 工具,向模型提交当前任务相关的代码上下文,是用户可以合理预期的行为。
但这次快照做了几件完全不同的事:
数据范围不同
推理需要的是当前任务上下文;快照拿的是整个本地 Git 元数据库。历史中已经删除的代码、旧配置、未推送分支、reflog 和内部 remote 地址,都可能存在于 .git。
触发方式不同
ZCode 的安全操作确认文档说,Agent 的文件修改、命令和网络操作会在执行前展示并确认。但 Repo Snapshot Sidecar 不是普通 Agent Tool Call,它在后台捕获,不走同一套可见确认流程。
控制能力不同
官方 UI 没有一个清晰的“不要备份/上传我的工作区”开关。相关设置全部关闭后,机制仍然运行。
密钥归属不同
用户本机没有解密私钥,服务端下发公钥并接收被包装的 AES key。这更像服务端可消费的数据采集链路,而不是用户自主控制的本地备份。
官方披露粒度不同
隐私政策写了会处理“用户在对话中提交的文本、文件和代码”,但截至 2026 年 9 月 18 日,没有找到“自动扫描完整工作区、包含 .git、额外收集 Skills/MCP/Hooks/AGENTS.md、上传到对象存储”的公开说明。
同意把代码片段交给模型,不等于明确同意把完整 Git 历史做成服务端可解密快照。
如何检查自己的 ZCode
下面这些检查都是只读的,不会触发上传。
1. 查看快照目录占用
du -sh ~/.zcode/v2/checkpoints2. 查找 pending 加密包
find ~/.zcode/v2/checkpoints -type f -name '*.tar.gz.enc' -print3. 查看每个工作区的状态
find ~/.zcode/v2/checkpoints -name state.json -print重点关注这些字段:
workspacePath
lastCompressedSize
activeUpload
pendingUpload
attemptCount
lastAcceptedManifestHash
4. 只统计 Manifest,不读取源码
Manifest 本身已经列出相对路径和字节数。可以统计:
- 文件总数和总体积;
.git文件数和体积;- 是否包含
.git/config、refs、reflog 和 LFS; - 是否存在
extra-manifests。
不要公开 Manifest 原文,因为它会暴露项目结构、分支名和内部文件路径。
怎么阻断
目前没有找到 ZCode 官方提供的快照上传开关。按确定性从高到低,能做的是:
屏蔽阿里云 OSS 地址能不能阻止上传?
可以阻止密文真正离开电脑,但不能阻止 ZCode 扫描、打包和加密项目。
当前客户端不会把 OSS Host 写死在应用里。它先请求 zcode.z.ai/api/v1/snapshot/upload-credential,由服务端动态返回本次上传使用的 OSS Host、Object Key、签名和 Security Token。因此,只封锁当前观察到的某一个 OSS 地址并不可靠:下次凭证可能返回不同 Bucket、Region 或域名。
几种拦截方式的实际效果不同:
| 拦截方式 | 阻止外传 | 阻止本地打包 | 主要影响 |
|---|---|---|---|
| 屏蔽当前 OSS Host | 可以 | 不可以 | Host 可能动态变化,规则容易失效 |
屏蔽 *.aliyuncs.com | 大概率可以 | 不可以 | 会同时影响电脑上的其他阿里云服务 |
| 按进程禁止 ZCode 访问 OSS | 可以 | 不可以 | 需要 LuLu、Little Snitch 等支持进程规则的出站防火墙 |
屏蔽整个 zcode.z.ai | 可以 | 可以 | 上传凭证在扫描前获取,但登录、模型、额度等 ZCode 功能也会一起失效 |
锁定空的 ~/.zcode/v2/checkpoints | 可以 | 可以 | Checkpoint、时间线或恢复能力可能不可用 |
| 退出账号并完全退出 ZCode | 可以 | 可以 | 客户端拿不到登录 token,云端功能无法继续使用 |
这里还有一个容易忽略的点:网络拦截失败后,pending 包不会立刻消失。 当前版本对单个 pending 包默认最多尝试 3 次、最长保留 24 小时。也就是说,屏蔽 OSS 解决的是“暂时传不出去”,并没有解决 CPU、磁盘占用和后台打包;规则一旦失效,已经生成的 pending 包仍可能继续尝试上传。
如果仍然需要使用 ZCode,更合理的组合是:
- 退出 ZCode 后先隔离现有 pending 文件;
- 使用进程级防火墙阻止 ZCode、ZCode Helper 和
zcode-cli访问 OSS; - 锁定重新创建的空 checkpoints 目录,从文件生成阶段阻断;
- 只把 shallow clone 或 Git worktree 交给 ZCode,避免暴露主仓库完整对象库。
1. 不要让敏感仓库进入 ZCode
这是唯一不依赖客户端实现细节的办法。商业项目、客户代码和带历史秘密的仓库,不要直接作为 ZCode 工作区打开。
2. 使用隔离副本
确实需要使用时,可以准备:
- 不含历史对象的 shallow clone;
- 单独的 Git worktree;
- 删除敏感 remote、历史 refs 和 LFS 缓存的临时副本;
- 虚拟机或单独用户环境。
当前扫描逻辑对根目录是 .git 文件的 worktree 和 .git 目录的普通 clone 处理不同。使用 worktree 可以避免把主仓库完整对象库直接放在工作区根目录。
3. 退出登录并完全退出 ZCode
当前快照入口必须先从 token provider 取得登录 token;取不到 token 时会直接返回。仅关闭“优化体验”或“仓库快照索引”不够。
4. 隔离现有 pending 文件
退出 ZCode 后,可以先把 ~/.zcode/v2/checkpoints 整体移动到离线隔离目录,再检查内容。只删 .enc 文件并不能保证不再生成,下一次捕获可能重新创建 baseline。
5. 文件系统层阻止重建
在 macOS 上可以对重新创建的空 checkpoints 目录使用 immutable flag;Linux 可以使用 chattr +i。这是非官方 workaround,会让 ZCode 的相关恢复能力失效,也可能产生后台 IO 错误,但能从文件生成阶段切断后续上传。
我更关心的是行业问题
这件事并不只属于 ZCode。
Agentic Coding 工具正在从“读当前文件”变成“接管整个工程工作流”。为了实现跨轮恢复、语义索引、仓库 Wiki、Memory 和多 Agent 协同,它们越来越倾向于维护一份完整的项目表示。
真正的问题不是能不能做,而是四件事有没有说清楚:
- 默认范围是什么? 当前文件、当前仓库,还是完整 Git 历史?
- 数据去哪里? 本地索引、厂商服务器,还是第三方对象存储?
- 谁持有解密能力? 用户、企业,还是服务端?
- 用户能否真正关闭? 是关闭训练,还是关闭捕获、上传和保留?
我在商业化项目的 Loop Engineering 实践里反复强调,Harness 的价值不只是给 Agent 更多工具,而是把权限、证据和停止条件变成硬边界。
AI Coding 工具也应该接受同样的要求:它可以很强,但不能把“强”建立在用户不知道自己的整个 Git 历史已经被装箱的前提上。
写在最后
ZCode 这套机制最值得批评的,不是使用 OSS,也不是使用服务端可解密的信封加密。真正越界的是组合在一起的产品选择:
- 默认捕获;
- 显式包含完整
.git; - 顺带收集全局 Agent 配置;
- 后台申请凭证并直传;
- 相关开关无法关闭;
- 官方文档和隐私政策没有对等披露。
“代码备份”听起来像是在保护用户。
但当备份范围由厂商决定、密钥由厂商控制、上传由后台触发、关闭入口又不存在时,它就不再只是一个备份功能,而是一条应该被公开解释的数据管道。